多刊出台AI使用规范,学术诚信与版权争议升温
2026-08-24 06:58:46 来源:checkbloc 栏目:查重检测
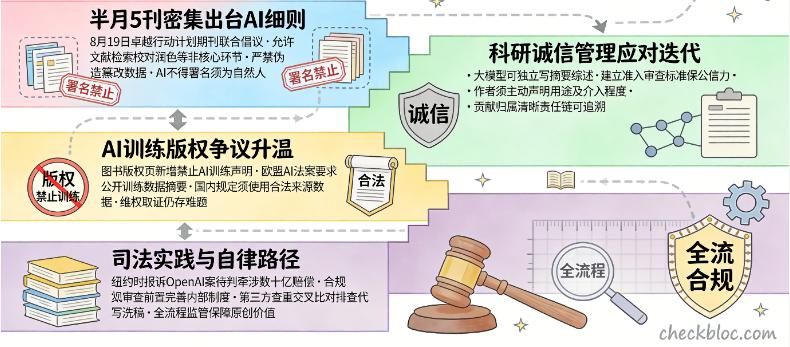
2026年8月,国内学术期刊圈有了新一轮制度更新。半个月的时间,至少有5家知名期刊都给出了各自的AI使用细则。8月19日,中国科技期刊卓越行动计划的期刊以及集群都推出了专项倡议,这倡议明确要求构建人工智能使用披露制度。这一系列动作显示,学术界对生成式工具的管控已经到了比较实际的阶段了。
一、期刊AI新规为何聚焦署名与披露?
细读此次集中亮相的行业指引,就能知晓,没有任何一家期刊都采用全面禁用的策略。各出版方都选择了规范的使用路线。在作者这一方面,像《中国经济问题》这类刊物都允许把AI工具用在文献检索、文字校对、语言润色以及格式整理这些非核心环节上。但红线也挺清晰的,而且严禁使用算法来伪造、篡改数据、案例或者研究结果。
在编辑审稿时,规则会更严格。相关指南显示,编辑人员可借助智能程序对基础文字进行校对,对格式加以优化,可否擅自修改论文的核心观点、重要论证以及最终研究结论?另外,有一份重磅文件指出,不能把任何生成式人工智能程序当作论文的通讯作者、第一作者或者参与作者,所有稿件署名主体都得是具备独立民事行为能力的自然人。
二、科研诚信管理如何应对技术迭代?
学术界不是第一次遇到技术迭代带来的冲击,今年8月就形成了集体响应,这显然是触及到不可回避的临界点。大模型已经能独立撰写摘要、生成数据分析报告,还能完成完整的学术综述,投稿材料里机器生成的痕迹也越来越多。期刊方知道,要是不马上构建起明确的准入与审查标准,学术评价体系的公信力就会承受很大的考验。
期刊管理方搞了个折中方案,把效率和伦理都纳入考量,这是面对这种现实状况。AI深度参与前期资料梳理与后期排版校对工作,这能大减少重复劳动,不过,作者得主动声明具体用途以及介入程度,确保每项学术贡献都清楚、责任链条可追溯。这种精细化管理模式,就是当下期刊AI使用规范的落实,也给后续内容审核提供了可操作的依据。
三、AI训练版权争议如何界定合规边界?
期刊层面的规范制定是零星的,AI训练数据的版权争议正朝着更广泛的知识生产领域不断扩散。最近,有图书版权页上有一条明确的声明,就是“禁止将本书内容用于人工智能训练”。这一行为直接表明了原创作者大量内容被低成本抓取、重组后所引发的焦虑。当文风、画风还有思考逻辑都可能被算法瞬间被拆解、套用的时候,传统版权保护机制正承受着前所未有的压力。
国内外监管方面已经陆续有了相应的配套政策,这个问题就在这之中。欧盟的《人工智能法案》规定,通用模型的提供者得把训练数据摘要公开,而且要构建出符合版权规则的治理框架。我国有关管理办法也明确了底线,生成式服务提供者得用合法来源的数据,要是涉及知识产权,就不能侵害他人合法权益。即便方向相同,实际操作时,数据集获取的门槛挺高的,维权取证也挺难的。
四、司法实践与行业自律的未来路径
法律方面的博弈也十分激烈。《纽约时报》起诉OpenAI和微软一案,这案子很受关注,该案涉及数十亿美元的潜在赔偿责任,其判决方向对全球内容产业的版权定价影响很大。在司法裁决落地之前,行业自律以及事前防范成了主流的做法。科研人员与学术机构正慢把合规审查放在前面,靠完善内部管理制度来防范潜在的侵权风险。
在这个转型之际,学术成果的原创性验证就变得相当关键了。不少研究团队开始引入第三方检测机制,借助成熟的论文查重平台对文本相似度进行交叉比对,以此排查未经授权的AI代写或者洗稿行为。这种技术手段的常态化应用,对期刊提出的披露要求的落实是有利的,而且在纠纷发生时能给关键的数据提供支撑。
生成式技术把知识生产流程给重塑了,这已经确定了,单靠技术封锁,创新的步子是没法阻止的。学术期刊与版权持有者,把AI使用规范细化了,正在寻找一条技术与伦理共存的可行办法。要保证原创价值不被稀释,就得在明确权责边界的情况下强化全流程监管,这样才能让学术生态健康地发展。
论文查重降重:https://www.checkbloc.com/
Turnitin查重:https://tt.checkbloc.com/
iThenticate查重:https://it.checkbloc.com/
万方查重:https://wanfang.checkbloc.com/
维普查重:https://weipu.checkbloc.com/
本网站部分文章转载自互联网以及作者的分享,如本网站所引用的文章涉及著作权问题, 请您及时通知本站,我们将及时妥善处理。